产品评测 · 工作流
AI Product Evaluation Workbench
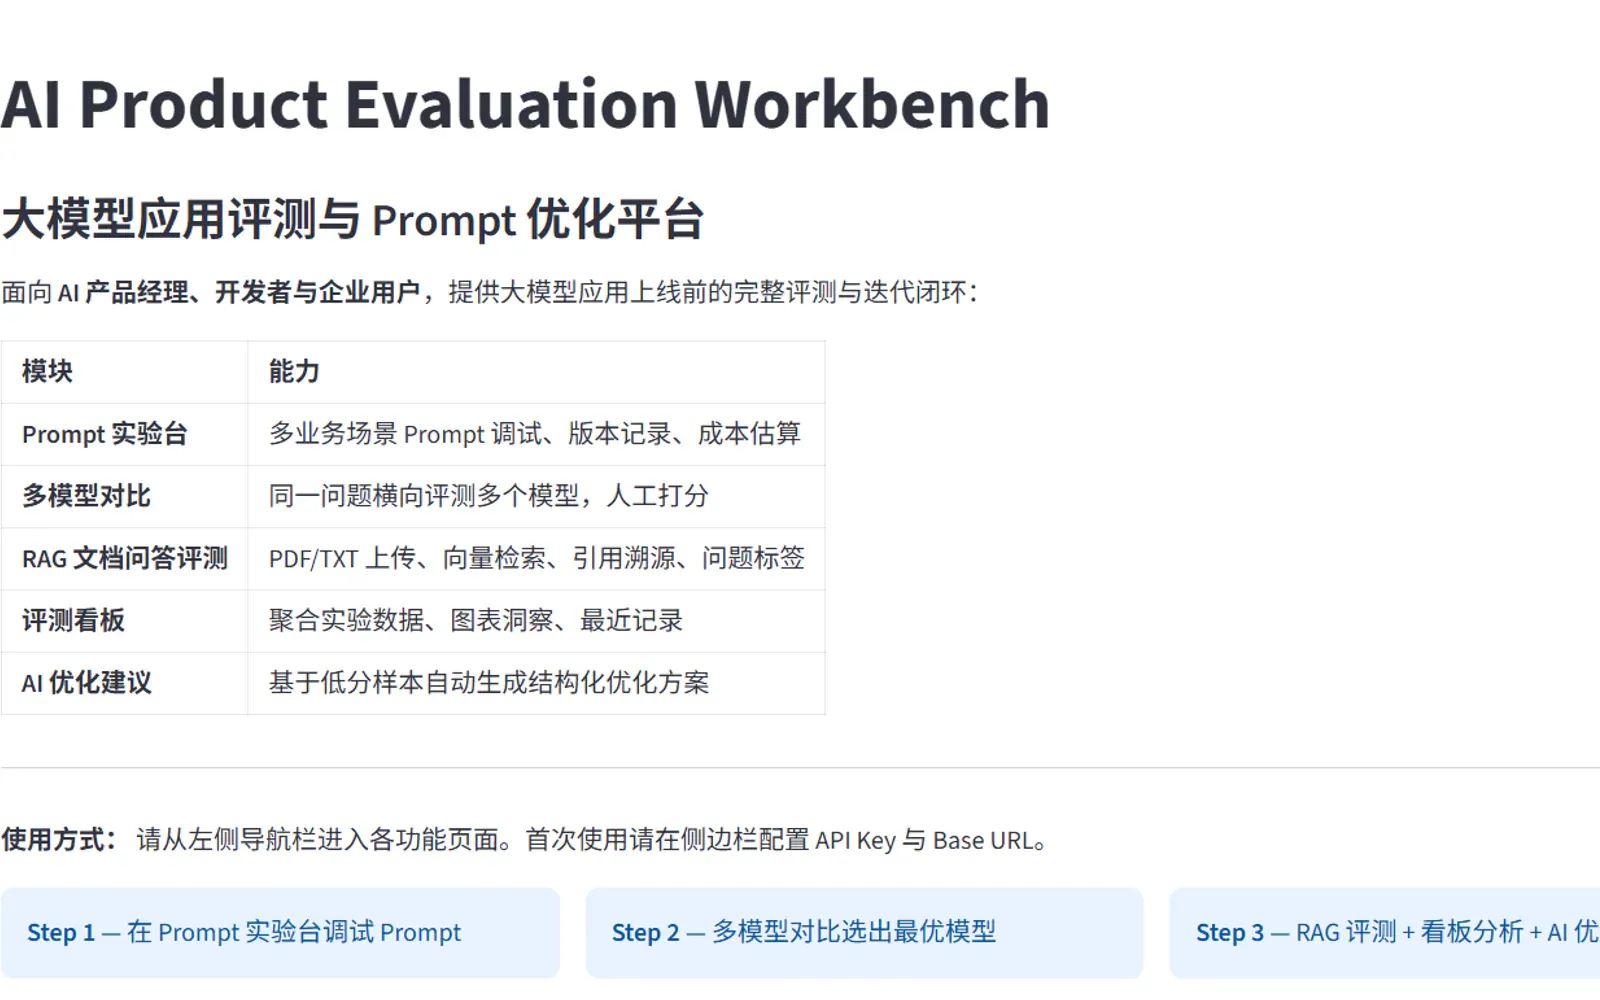
基于 Streamlit 的 AI 产品评测工作台,覆盖 Prompt 实验、多模型对比、RAG 文档评测、反馈分析与优化建议。
- 用户问题
- 普通对话界面难以同时保留实验条件、横向结果与人工判断,零散试用也不利于复盘。
- 产品方案
- 在 Streamlit 工作台中固定场景、Prompt、模型与样本条件,串联输出留存、人工评分、RAG 问题标注、反馈分析和下一轮优化记录。
- 我的职责
- 产品设计 / 评测体系 / 原型开发
- 真实产出
- 在线作品与公开仓库已可访问;当前原型提供 Prompt 实验、多模型对比、RAG 文档评测与反馈分析入口。
先确定为谁解决什么问题
- 目标用户
- 需要验证模型能力、比较 Prompt 或模型版本,并保留评测依据的 AI 产品人员。
- 产品目标
- 让一次模型判断能够回到实验输入、模型输出、人工评分和问题标签。
- 当前状态
- 在线作品 · 公开仓库 · 持续迭代
我的工作
- 拆解 Prompt、模型与样本之间的实验关系
- 设计多模型对比和人工评分流程
- 整理 RAG 问题标签与反馈分析维度
- 完成 Streamlit 原型和演示数据入口
模型进入哪一步,为什么
大模型输出会受到 Prompt、模型与上下文影响,需要用结构化实验和人工复核整理能力边界。
- 支持 OpenAI-compatible API,模型连接与业务评测数据分开配置
- Prompt 实验保留输入、输出和人工评分
- 多模型对比记录延迟、Token 与成本字段,供同条件观察
- RAG 评测通过问题标签和人工判断暴露检索或回答缺陷
哪些判断不能交给模型
必须由人确认
- 确认样本是否代表目标场景
- 复核主观评分
- 决定是否采纳优化建议
安全与使用边界
- 演示数据仅用于展示流程
- 自动建议不替代人工结论
- 敏感业务数据不进入公开演示
从输入到反馈的完整路径
- 01选择评测场景
- 02配置 Prompt 与模型
- 03提交样本
- 04保留模型输出
- 05人工评分或标注
- 06查看对比与问题分布
- 07记录下一步优化
现有材料与缺失状态
用什么观察产品是否更可靠
- 人工评分
- 模型平均分
- RAG 问题标签分布
- 测试样本数量
- 响应时间记录
- Token 与成本记录
当前重点
在线作品与公开仓库已可访问;当前原型提供 Prompt 实验、多模型对比、RAG 文档评测与反馈分析入口。
明确哪些情况不算成功
已识别失败
- 平均分掩盖单类失败
- 样本不足却形成泛化结论
- 模型或 Prompt 条件变化后仍直接比较
异常场景
- 模型连接失败
- 结构化输出不完整
- RAG 未命中有效证据
- 演示数据被误当成真实业务结果
从问题回到下一轮行动
CURRENT_REPOSITORY
模型试用、RAG 评测和反馈分析分散在不同操作中。
- 判断
- 缺少共同的数据入口和可回看的产品评测界面。
- 调整
- 仓库将五个评测模块与演示数据整合到同一 Streamlit 应用。
- 结果
- 当前公开仓库已包含 Prompt 实验、多模型对比、RAG 评测、反馈看板与 AI 优化建议模块。
- 下一步
- 用真实业务测试集继续校准评分说明和失败标签。
我从这个项目留下什么判断
评测的重点不是制造单一总分,而是让能力、成本和风险的判断有明确依据。
后续计划
- 补充真实业务测试集
- 校准人工评分一致性
- 完善模型与 Prompt 版本记录
来源说明
已依据公开 GitHub 仓库与在线作品校对;演示数据仅用于验证评测流程,不代表真实业务效果。
产品判断
这个项目把“试一下模型”拆成可记录的产品实验:先固定场景、输入和模型条件,再观察输出、人工判断与失败类型。
当前仓库包含
- Prompt 实验台与场景模板
- 多模型输出对比
- RAG 文档评测与问题标签
- 用户反馈和评测看板
- 基于现有记录生成的优化建议
使用边界
仓库内的演示数据用于验证页面与流程,不代表真实用户规模或业务效果。延迟、Token 和成本是评测记录字段,也不构成对模型表现的预设结论。