工作流
AI PDF Learning Assistant
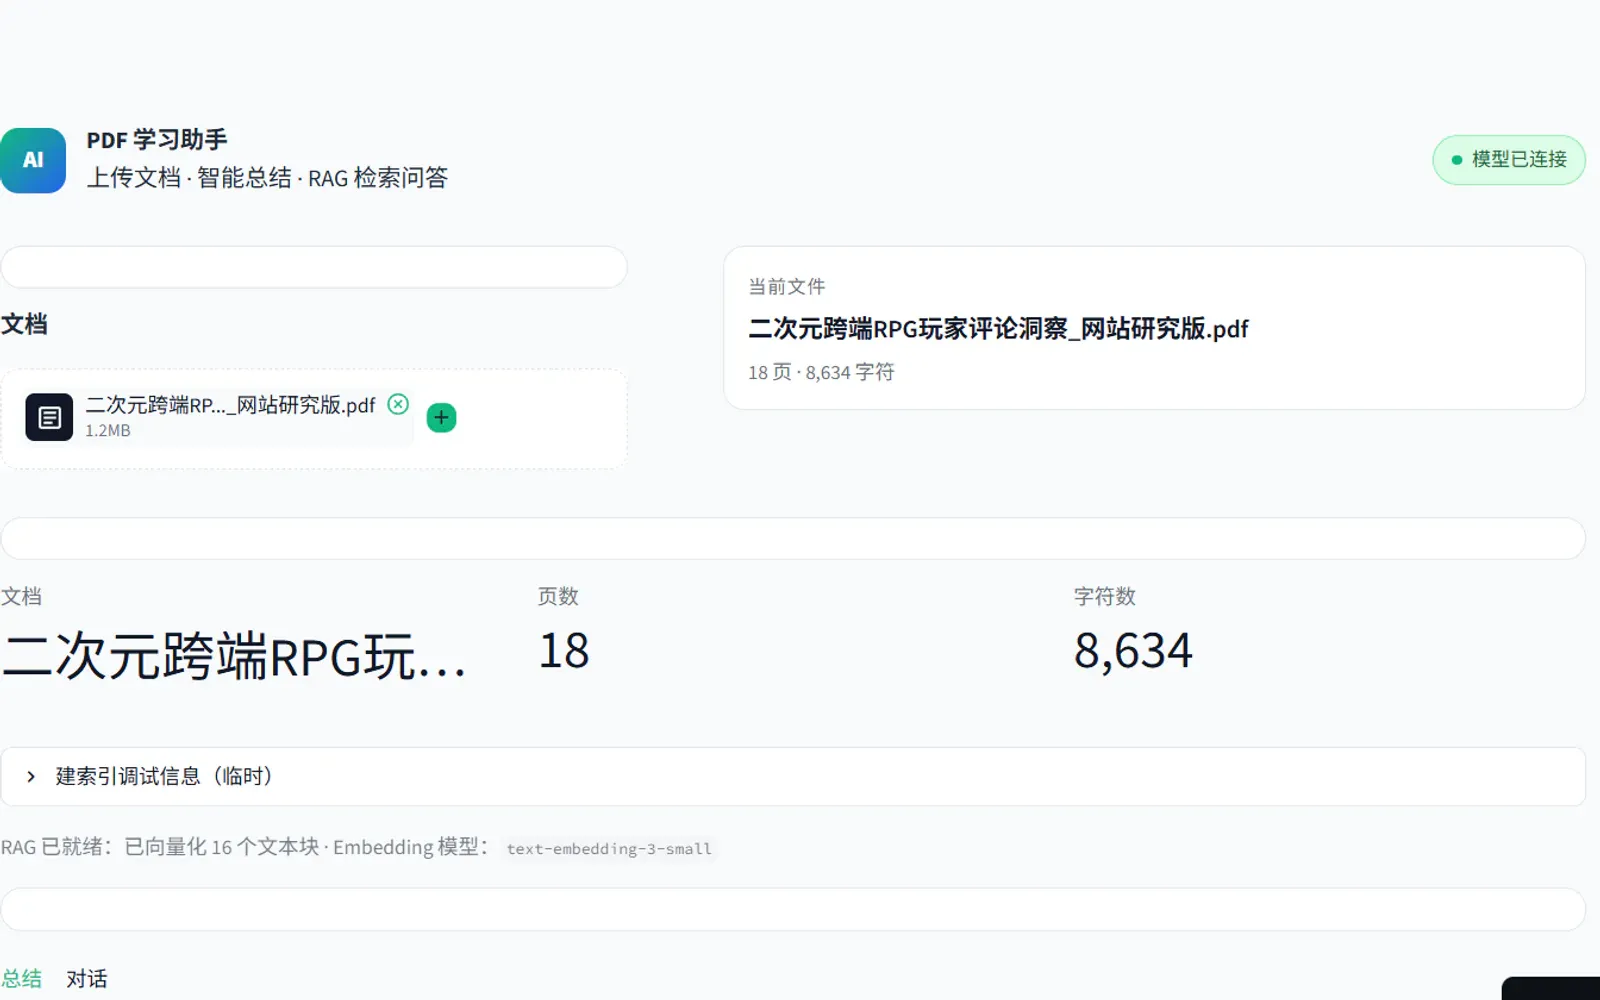
基于 Streamlit、pypdf、LangChain 与 ChromaDB 的 PDF 学习助手,支持结构化总结和带来源片段的 RAG 问答。
- 用户问题
- 长 PDF 阅读成本高,普通模型总结难以追溯来源,后续追问也容易离开文档内容。
- 产品方案
- 用 pypdf 提取文本,经 LangChain 切分并写入 ChromaDB;产品侧把结构化总结、检索问答和来源片段组织成可回到原文核查的学习路径。
- 我的职责
- 产品设计 / RAG 流程 / 原型开发
- 真实产出
- 在线作品与公开仓库已可访问;当前原型提供 PDF 总结与 RAG 问答,仅支持可提取文本的 PDF。
先确定为谁解决什么问题
- 目标用户
- 需要快速理解文本型 PDF,并希望问答能够回到文档片段的学习者。
- 产品目标
- 降低长文档进入成本,同时保留回答与原文证据之间的联系。
- 当前状态
- 在线作品 · 公开仓库 · 可运行原型
我的工作
- 拆解 PDF 上传、解析、切分、检索与问答流程
- 设计结构化总结和来源片段呈现
- 处理文本缺失、检索不足和模型连接异常
- 完成本地 Streamlit 原型
模型进入哪一步,为什么
大模型可用于总结和回答,但必须结合文档检索结果,并对缺少证据的情况保持克制。
- 总结与问答使用分开的提示与输出结构
- 检索结果作为回答上下文,并在页面中展示来源片段
- 本地向量库用于保存文档切片
- 没有有效文本或检索证据时提示限制
哪些判断不能交给模型
必须由人确认
- 确认 PDF 是否成功提取文本
- 核对回答与来源片段
- 对重要结论回看原文
安全与使用边界
- 不宣称支持 OCR
- 回答不能替代原文核查
- 敏感文档应在合适环境中处理
从输入到反馈的完整路径
- 01上传文本型 PDF
- 02提取文档文本
- 03切分并向量化
- 04生成结构化总结
- 05输入问题
- 06检索相关片段
- 07生成回答并展示来源
现有材料与缺失状态
用什么观察产品是否更可靠
- 文本提取完整性
- 总结结构可用性
- 检索相关性
- 回答与来源一致性
- 失败提示清晰度
当前重点
在线作品与公开仓库已可访问;当前原型提供 PDF 总结与 RAG 问答,仅支持可提取文本的 PDF。
明确哪些情况不算成功
已识别失败
- 扫描件被当作空文档
- 回答引入片段之外的信息
- 来源片段相关但不能支撑结论
异常场景
- 扫描件无可提取文本
- 加密或损坏 PDF
- 检索片段与问题无关
- 模型 API 不可用
从问题回到下一轮行动
CURRENT_REPOSITORY
总结和问答如果没有来源展示,用户难以判断内容是否来自文档。
- 判断
- RAG 产品需要把证据片段放回用户的阅读路径。
- 调整
- 仓库整合文本解析、结构化总结、向量检索、问答和来源片段展示。
- 结果
- 当前公开仓库提供文本型 PDF 的本地可运行原型,不包含 OCR。
- 下一步
- 继续补充检索失败和引用一致性的测试样本。
我从这个项目留下什么判断
文档助手的关键不是替用户读完,而是帮助用户更快定位值得回到原文核查的内容。
后续计划
- 扩展检索失败样本
- 检查回答与来源一致性
- 改善长文档处理提示
来源说明
已依据公开 GitHub 仓库与在线作品校对;仅支持可提取文本的 PDF,不宣称具备 OCR。
学习闭环
上传文档后,用户可以先看结构化总结,再围绕具体问题检索片段并生成回答。来源片段是回到原文核查的入口,不等于自动完成事实验证。
能力边界
当前原型面向可提取文本的 PDF。扫描件、复杂表格和图片内容不在既有能力范围内;在线作品中的回答仍需结合来源片段回到原文核查。