游戏 AI · 工作流
AI 游戏增长投放与实验评测工作流
基于 Dify 的游戏增长诊断与实验评测工作流,区分事实、假设、人工确认和结果复盘,并保留真实运行与边缘输入评测记录。
首次 Streaming 运行
103,817 TokensPhase 2 Workflow 成功
每个 Case 单次 POST、无自动重试v1 平均耗时
P50 123.2945 秒,P95 129.563816 秒v2 两个边界 Case 规则分
Judge 未执行,稳定性未验证v2 Token 增幅
质量改善伴随明显性能退化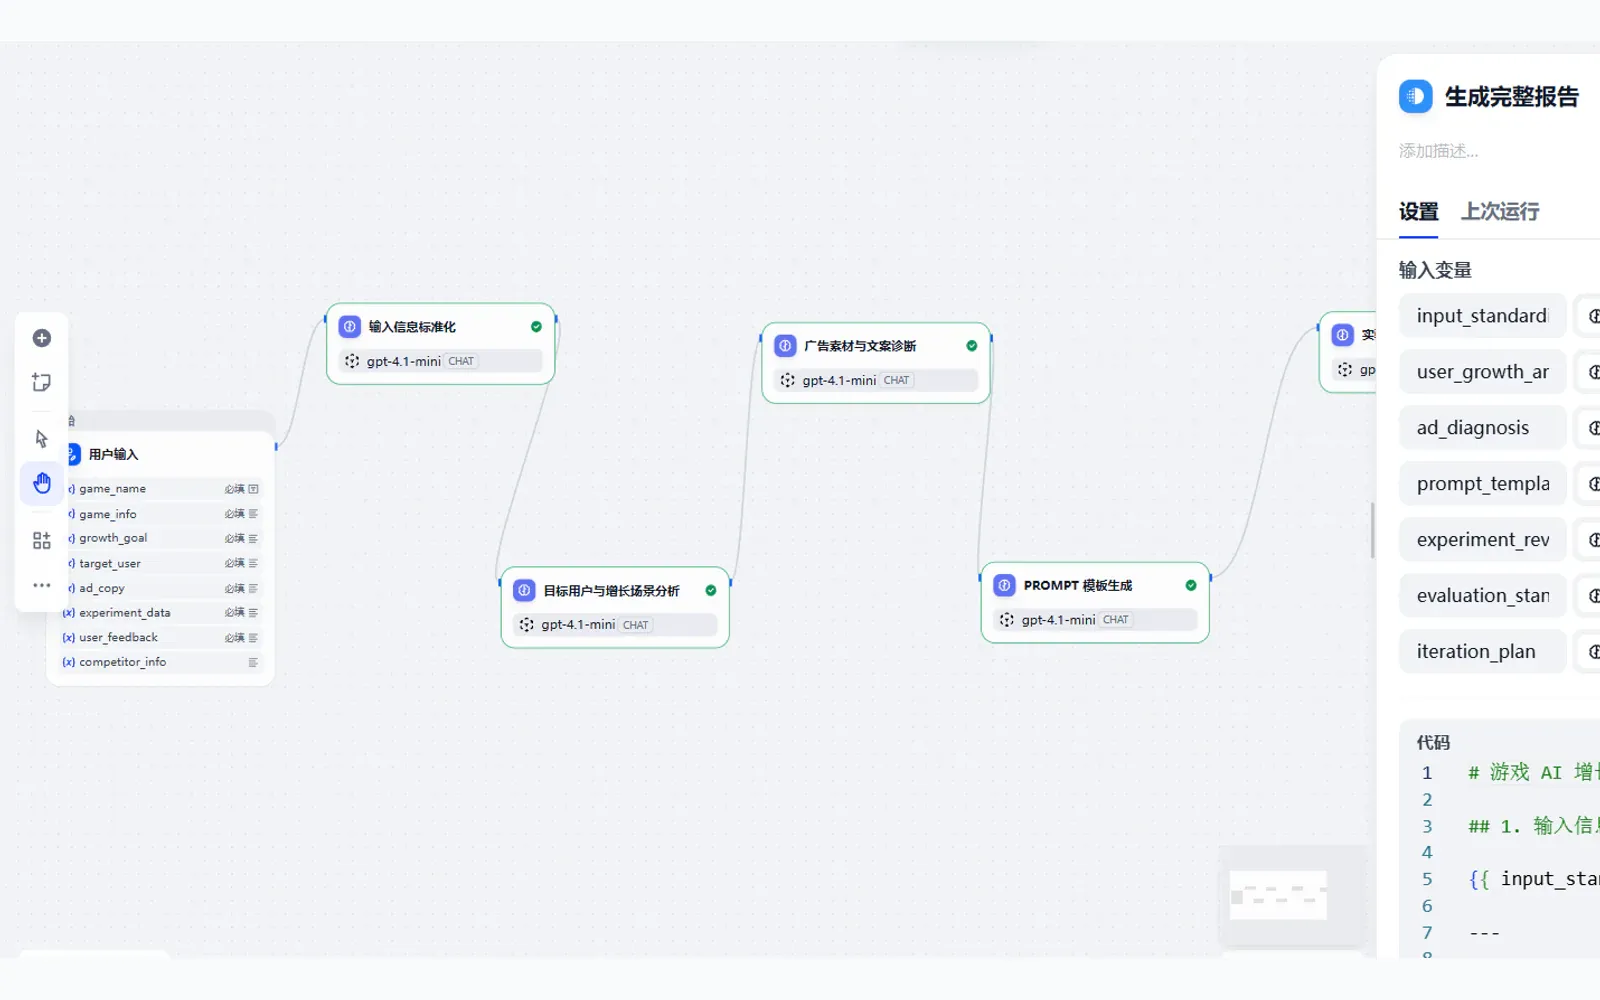
- 用户问题
- 素材问题、用户假设、生成建议和实验复盘容易分散在不同文档中,模型输出也可能缺少依据。
- 产品方案
- 用 Dify 工作流区分已知事实、素材问题与待验证假设,再连接人工确认、实验记录和复盘字段,避免模型直接给出投放结论。
- 我的职责
- 需求拆解 / 工作流设计 / 评测框架
- 真实产出
- 在线 Dify 工作流已可访问;Phase 2 三次真实流式运行全部完成,评测同时保留 Token、延迟与人工复核边界。
为什么做,以及核心问题是什么
为什么做
游戏增长工作同时处理产品信息、广告素材、实验数据、用户反馈和竞品信息。输入分散、口径冲突时,模型很容易把推断写成当前业务事实。
原有流程 / 用户任务
增长产品或投放人员需要人工整理材料、诊断素材、沉淀 Prompt、定义评测标准并形成下一轮方案;结论和证据散落在多个文档。
核心问题
用 Dify 工作流生成一份可审计的 7 章报告,并把事实、可计算结果、合理推断、待验证假设和数据缺口明确分开。
为谁解决什么任务
游戏增长产品经理
- 核心任务
- 把产品、素材、实验与反馈整理为下一轮增长方案。
- 典型场景
- 版本投放复盘、增长问题诊断与迭代评审。
- 主要目标
- 快速形成结构完整、证据边界清楚的诊断报告。
- 主要阻碍
- 输入分散、指标口径冲突、结论难追溯。
买量 / 广告投放人员
- 核心任务
- 诊断素材与文案,并定义下一轮实验。
- 典型场景
- 素材迭代、渠道适配与 A/B 实验准备。
- 主要目标
- 得到可执行而不是泛泛而谈的修改建议。
- 主要阻碍
- 依赖个人经验、缺少基线时模型仍可能给出量化提升。
内容 / 创意运营
- 核心任务
- 沉淀可复用 Prompt 与创意检查标准。
- 典型场景
- 多素材、多受众和多渠道内容准备。
- 主要目标
- 让经验可复用,并保留人工判断位置。
- 主要阻碍
- Prompt 难沉淀、文案同质化、反馈与数据相互冲突。
AI 产品 / 数据分析团队
- 核心任务
- 评测长工作流的输出完整性、幻觉、耗时和成本。
- 典型场景
- Workflow 回归、Bad Case 复盘和审计。
- 主要目标
- 区分模型问题、规则误报、工程问题和业务问题。
- 主要阻碍
- 长链路 Token 高、Judge 未启用、稳定性样本不足。
问题、场景与证据放在同一张表里
| 痛点 | 发生场景 | 影响 | 证据 / 来源 | 优先级 |
|---|---|---|---|---|
| 输入信息分散 | 需求准备 | 产品、素材、实验与反馈难统一口径。 | 工作流问题拆解,待用户验证 | P0 |
| 素材诊断依赖个人经验 | 广告诊断 | 结论难复用,也难映射到具体实验。 | 模拟业务案例 | P1 |
| 实验指标与用户反馈冲突 | 复盘 | 模型可能选择一方并做过度因果归因。 | 边界 Case 真实运行 | P0 |
| 缺少基线仍输出量化改善 | 报告生成 | 把无依据数字写成业务结论,直接损害可信度。 | v1 人工复核确认 | P0 |
| 长工作流延迟和 Token 高 | 10 节点串行运行 | v2 质量提升但性能明显退化。 | v1 / v2 真实运行 | P1 |
| 自动规则与真实问题混淆 | Bad Case 筛选 | 误报可能被当成产品缺陷。 | v1 人工复核 | P0 |
按 P0 / P1 收敛,而不是一次塞满
P0 · 核心闭环
作为增长产品经理,我希望输入先被校验和标准化,从而让后续节点使用相同口径。
验收:缺少基线或字段冲突时明确标记,不自动补造。作为投放人员,我希望报告完整渲染 7 章且没有残留变量,从而可以进入人工评审。
验收:7/7 章节标题与正文完整,无未解析 Jinja。作为业务审核者,我希望事实、推断、假设和目标值分开,从而避免把模型建议当成当前结果。
验收:缺少证据时使用“待验证 / 数据缺口”,不得生成具体改善幅度。作为评测人员,我希望每次真实运行保留 run_id、节点、Token、耗时与 POST 次数,从而审计失败和成本。
验收:Streaming 单次 POST、无隐式重试,运行证据完整。
P1 · 重要增强
作为 AI 产品人员,我希望比较 v1 / v2 的质量、耗时和 Token,从而判断优化是否值得。
验收:同时展示规则分改善与性能退化,不只展示单一总分。作为评测人员,我希望自动候选经过人工复核,从而区分真实缺陷、误报与正常行为。
验收:候选数不直接等于真实 Bad Case 数。
MVP 核心、增强项与后续规划
MVP 核心
保证输出可用、可信且可审计。
- 输入校验与标准化
- 7 章完整渲染与无残留 Jinja
- 禁止捏造当前业务结果
- Streaming 单次 POST 与运行审计
重要增强
补强 Prompt、规则与性能定位。
- Prompt 模板与事实 / 假设约束
- 边界用例回归
- 节点耗时与 Token 分析
- Bad Case 归因与人工复核
后续规划
当前没有足够证据,不写成已完成。
- LLM Judge
- 真实重复运行稳定性
- 完整 20 Case
- 团队看板与导出
用九个字段概括产品定义
- 目标
- 把分散增长输入整理为可审计的 7 章诊断与迭代报告。
- 用户
- 游戏增长产品、买量投放、内容运营与 AI / 数据分析团队。
- 场景
- 素材诊断、实验复盘、Prompt 沉淀、评测标准与下一轮迭代。
- 核心功能
- 输入标准化、用户与场景分析、素材诊断、Prompt、复盘、评测标准和迭代方案。
- 输入
- 产品信息、广告素材、实验数据、用户反馈和竞品信息。
- 处理
- 10 节点串行 Workflow;每个节点有明确输入、输出与真实性约束。
- 输出
- 7 章 Markdown 报告,区分事实、计算、推断、假设、数据缺口和行动。
- 成功标准
- 7/7 章节完整,无变量残留,无依据数字被阻断,运行证据可追溯。
- 风险
- 幻觉、指标口径、因果过度归因、Prompt 注入、长链路性能与小样本误判。
本期做什么,也明确不做什么
本期包含
- 10 节点 Dify 工作流与 7 章报告
- 输入校验、事实 / 假设分层与数字约束
- Streaming 运行审计与规则评测
- 三条白名单 Case 与边界回归
本期不包含
- 自动执行真实广告投放
- LLM Judge 作为当前质量证据
- repeat_count=1 的稳定性结论
- 完整 20 Case 与真实商业效果判断
后续验证
- 真实重复运行稳定性
- 完整测试集与 Judge 小规模校准
- 真实增长团队使用与人工采纳情况
公开版本可运行并输出完整报告;任何业务指标都能回到输入证据,缺少基线时不得生成具体改善幅度。
完成、计划与假设严格分开
尚未开展真实用户访谈
已完成
- 基于 Dify YML、README、评测报告和模拟业务 Case 完成问题拆解。
- 形成目标用户假设、用户故事、PRD 与 MVP 结构。
未完成 / 待验证
- 访谈游戏增长、买量和内容运营人员。
- 验证报告结构、人工采纳、任务时间与真实数据字段。
顶层 Word 文件为空白占位。当前结论来自 Workflow 设计与模拟业务案例,不代表真实用户研究或商业投放效果。
从输入到人工确认的完整路径
- 01
用户输入
提交产品、素材、实验、反馈与竞品信息。
- 02
输入信息标准化
统一字段、口径与缺失状态,阻止无依据补全。
- 03
目标用户与场景分析
识别受众、增长任务和当前证据边界。
- 04
素材与文案诊断
定位创意问题,不把推断写成已发生结果。
- 05
Prompt 模板生成
沉淀可复用输入结构、约束和输出格式。
- 06
实验与反馈复盘
并列数据与定性反馈,指出冲突和缺口。
- 07
评测标准制定
定义指标、数据来源与验收方法,不代填阈值。
- 08
下一轮迭代方案
按已确认问题、假设和工程问题收敛 MVP。
- 09
生成完整报告
模板节点汇总 7 章,检查变量与结构。
- 10
输出
交付可审计报告,由业务人员确认后继续实验。
每张图都说明它解决什么问题
详情 Hero 使用真实工作流界面封面;正文继续用 Dify YML、章节检查和评测图表呈现可核验结构,不伪造产品截图。
数字旁边必须有证据状态
首次 Streaming Token
10 步、139.498 秒、无恢复 GET。
Phase 2 三 Case 总 Token
3 次 POST、3 次成功。
自动告警 → Confirmed → 独立问题
人工复核后合并为 1 个无依据量化问题。
LLM Judge
没有可审计的 Judge 分数或原始响应。
稳定性
不能宣称完成稳定性测试。
v2 边界回归
章节完整,但存在待人工确认候选与性能退化。
问题 → 定位 → 修复 → 回归验证
V1-ISSUE-001 · 无基线却输出量化改善
真实测试- 问题
输入没有留存率、获客成本或历史基线,报告仍生成具体改善幅度。
- 定位
实验复盘节点把未来目标写成当前可预期结果,自动规则又混入数字误报。
- 修复
Prompt 强制区分事实、数据缺口、待验证假设与目标阈值;缺少基线时禁止生成幅度。
- 回归验证
v1 六条自动告警经人工复核确认两条并合并为一个独立问题。
v2 · 首章变量映射为空
真实测试- 问题
模板变量名与 value_selector 映射不一致,导致第一章没有正确渲染。
- 定位
生成完整报告节点的变量引用与输入节点字段没有对齐。
- 修复
修正模板变量映射,并保留章节完整性自动检查。
- 回归验证
两个 v2 边界 Case 均通过 7/7 章节完整性复测。
v2 · 质量提升但性能退化
Review- 问题
两条边界 Case 规则分提高 19.72,但延迟增加约 103% / 177%,Token 增加约 43%–44%。
- 定位
更强约束与更长输出提高了完整性,也扩大了上下文和节点生成成本。
- 修复
继续裁剪上下文、压缩重复输出并分析最慢节点,不以降低核心真实性约束为代价。
- 回归验证
当前仍为 Review;完成候选人工复核和性能优化后才能进入稳定性测试。
明确不能被模型或页面夸大的部分
- 模拟业务数据
- 广告与业务输入均为模拟数据,只验证工作流结构、约束和评测方法。
- 无依据数字
- 缺少历史基线时,不得生成具体提升、留存、ROI 或获客成本结论。
- 指标与因果
- 需区分提升率与百分点、相关与因果、定量数据与用户反馈冲突。
- 自动评测
- 规则可能误报,Judge 尚未执行,任何候选都需要人工复核。
- 性能与配额
- 实际运行依赖 Workflow 权限、模型服务、配额和平台可用性。
- 安全与审计
- 不公开未脱敏 JSONL、密钥或重复 QA 临时文件;保留必要 run 证据。
本项目中的广告与业务输入为模拟数据,用于验证工作流结构、输出约束和评测方法,不代表真实商业投放效果。
以真实可核验的工作说明职责
- 把增长诊断拆成 10 个 Dify 节点和 7 章可审计输出。
- 设计事实、计算、推断、假设、数据缺口和行动的输出约束。
- 搭建真实 Streaming、规则评测、节点性能与 Bad Case 人工复核流程。
- 复盘无依据量化、变量映射和 v2 性能退化三个真实迭代案例。
- 坚持不把模拟业务输入、单次运行或自动告警包装成商业结果。
已依据 Dify v2 工作流文件、真实流式运行记录和评测报告校对;当前不提供 GitHub 入口,模拟业务输入不代表真实投放效果。
为什么保留这个案例
它补充了作品集中“如何把模型能力放进业务工作流”的思考:事实、假设、人工判断和真实实验结果必须分开记录。
当前证据边界
本页没有公开 GitHub 入口,也不展示虚构的投放、转化或效率数据。已有运行证据仅用于说明工作流可运行性、报告完整性和成本表现,不代表真实业务增长。