游戏 AI · 工作流
AI Game Content Copilot
Python/FastAPI 与 React/Vite 构建的游戏内容生成原型,覆盖七类文本场景、A/B/C 版本与五维评估。
真实模型调用
57 次生成、54 次优化样本 Token
来自自动调用记录导出生成 + 优化等待
不代表所有线上请求样本 API 成本
按公开价格与测算汇率估算单流程节省时间
场景估算,不是业务实测结果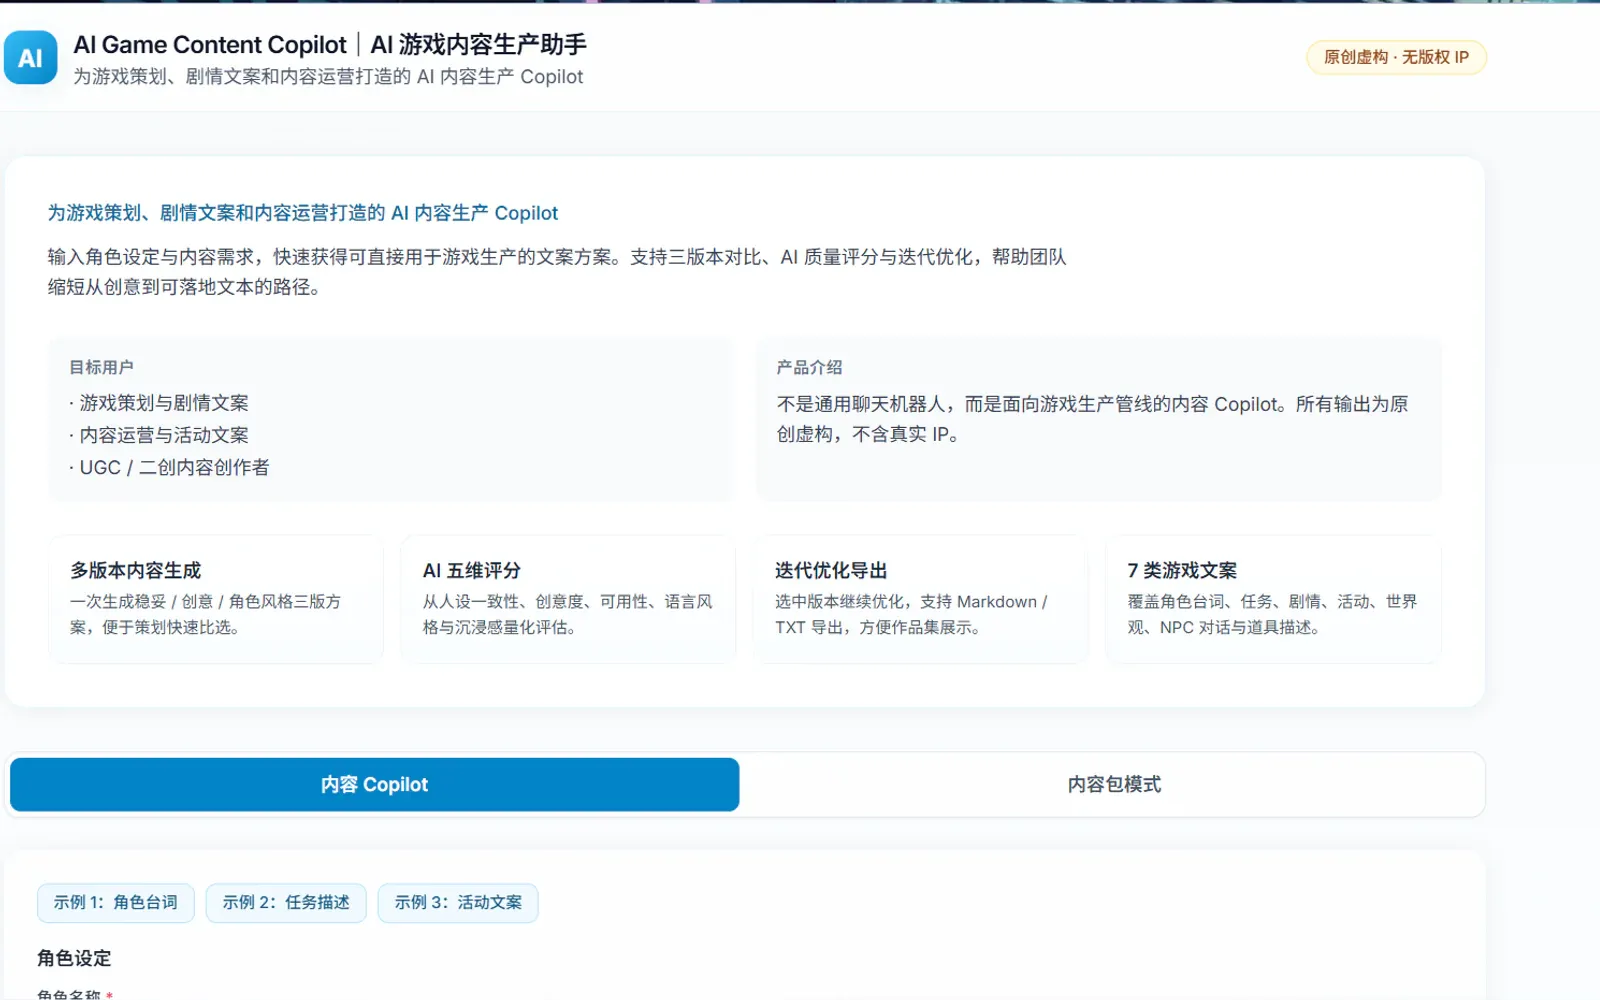
- 用户问题
- 开放式聊天难以稳定承接题材、语气、角色和长度约束,也不利于多版本比较。
- 产品方案
- 把内容需求拆成结构化输入、A/B/C 候选生成、五维检查提示、人工比选、反馈优化与文档导出,让模型产出进入可评审工作流。
- 我的职责
- 产品设计 / 工作流 / 前后端原型
- 真实产出
- 在线作品、FastAPI 文档与公开仓库均可访问;模型调用记录已通过线上接口成功导出为 XLSX。
为什么做,以及核心问题是什么
为什么做
游戏剧情、任务和活动内容需要同时满足角色、世界观、风格与长度约束。通用聊天模型可以快速起草,却难以稳定复现输入条件和比较多个方向。
原有流程 / 用户任务
策划通常先整理需求、搜索参考、反复改 Prompt,再把多个结果复制到文档中比较;评分、修改与导出又分散在不同工具。
核心问题
把“生成一段文本”改造成可评审的内容工作流:结构化输入、2–3 个实质不同的版本、五维检查、人工选择、定向优化与导出。
为谁解决什么任务
游戏剧情 / 内容策划
- 核心任务
- 形成角色对白、剧情片段、任务或世界观初稿,并比较不同创意方向。
- 典型场景
- 项目前期脑暴、版本活动策划、角色设定补全与临时文案需求。
- 主要目标
- 在可接受等待与成本内获得 2–3 个真正不同、值得继续编辑的版本。
- 主要阻碍
- 信息容易遗漏、输出结构不稳、人设漂移、版本同质化与评测缺少共同口径。
活动 / 内容运营
- 核心任务
- 根据活动目标、玩家分层和渠道,快速准备多个文案方向。
- 典型场景
- 活动主题文案、版本预热、社区互动话题与角色推广内容。
- 主要目标
- 让生成结果快速进入人工修改,并清楚说明适用受众与场景。
- 主要阻碍
- 需求变化快、文案反复修改、语气模板化且不同受众需要不同表达。
问题、场景与证据放在同一张表里
| 痛点 | 发生场景 | 影响 | 证据 / 来源 | 优先级 |
|---|---|---|---|---|
| 需求信息分散且容易遗漏 | 需求准备 | 关键角色、世界观或禁用项没有进入 Prompt。 | 场景分析,待访谈 | P0 |
| 模型输出结构不稳定 | 内容生成 | 缺字段、顺序变化,页面难以解析和横向比较。 | 项目测试,初步验证 | P0 |
| 角色人设或世界观漂移 | 长输入与复杂约束 | 人物行为与原始设定冲突,返工成本上升。 | 项目测试,初步验证 | P0 |
| 多个版本只有措辞差异 | 版本比较 | 表面有多个候选,实际没有增加创意覆盖。 | 项目测试,初步验证 | P0 |
| 缺少统一评价标准 | 方案选择 | 仍靠直觉比较,难解释选择原因。 | 场景分析,待验证 | P0 |
| 优化建议过于笼统 | 结果优化 | “增强细节”等表述无法直接转化为修改动作。 | 项目测试,初步验证 | P0 |
| AI 自评分偏宽松 | 结果评测 | 高分结果仍有明显问题,可能误导版本选择。 | 项目测试,尚缺人工盲评 | P0 |
| 异常后缺少恢复路径 | 超时、空结果或解析失败 | 用户不知道应重试、修改输入还是保留已有结果。 | 项目测试,初步验证 | P0 |
按 P0 / P1 收敛,而不是一次塞满
P0 · 核心闭环
作为游戏内容策划,我希望通过结构化字段补齐背景、角色、目标与限制,从而减少关键信息遗漏。
验收:必填项有示例;缺失时定位字段并保留已填写内容。作为游戏内容策划,我希望一次获得 2–3 个创意方向不同的版本,从而提高前期创意覆盖。
验收:差异体现在动机、冲突、结构或语言风格,不只是换词。作为游戏内容策划,我希望看到五维评分、依据与具体问题,从而理解候选版本的质量差异。
验收:每项评分附带依据,并提示 AI 评分仅供辅助。作为用户,我希望在模型超时或结构错误时获得中文恢复提示,从而继续任务而不是丢失输入。
验收:提供重新生成、返回修改和查看详情;默认折叠技术错误。
P1 · 重要增强
作为游戏内容策划,我希望在线编辑选中版本,从而把 AI 初稿转化为可用内容。
验收:保留原始生成内容与人工修改结果的区分。作为游戏内容策划,我希望导出 Markdown 或 TXT,从而进入后续文档流程。
验收:中文编码正常,并可选择是否包含需求摘要与评测信息。
MVP 核心、增强项与后续规划
MVP 核心
缺失会导致生成—比较—评测闭环无法验证。
- 7 类内容选择与结构化需求输入
- Prompt 组装、2–3 版本生成与固定 Schema
- 版本差异检查与五维评测依据
- 友好异常提示、结构修复与重试
重要增强
核心闭环成立后,继续提升可编辑性与任务恢复。
- 基础编辑与 Markdown/TXT 导出
- 单版本重试
- 生成状态反馈
- 用户侧任务历史(尚未实现)
后续规划
等待用户验证后再决定投入,避免提前堆叠复杂度。
- 角色 / 世界观知识库
- Prompt 版本管理
- 多人评论、共享与审批
用九个字段概括产品定义
- 目标
- 把游戏文本生成组织为可输入、可比较、可评测、可编辑和可导出的完整任务。
- 用户
- 游戏剧情 / 内容策划为核心,活动与内容运营为次级用户。
- 场景
- 角色对白、任务描述、剧情片段、活动文案、世界观、NPC 对话和道具描述。
- 核心功能
- 结构化需求、三版本生成、差异检查、五维评测、定向优化与导出。
- 输入
- 内容类型、角色与世界观、目标、风格、长度和禁用条件。
- 处理
- 输入校验 → Prompt 组装 → 模型调用 → Schema 解析 → 差异检查 → 五维评测。
- 输出
- 2–3 个候选版本、评分依据、优缺点、优化建议与 Markdown/TXT 文件。
- 成功标准
- 流程可独立完成、结果结构可控、版本有实质差异、失败可追踪、成本可估算。
- 风险
- 设定漂移、同质化、敏感数据、版权、长尾延迟、AI 自评误导与失败日志缺失。
本期做什么,也明确不做什么
本期包含
- 结构化字段、必填校验与 7 类内容入口
- 2–3 个候选版本和固定输出结构
- 五维评测、依据、问题与优化建议
- 基础编辑、Markdown/TXT 导出与异常兜底
本期不包含
- 企业级多人协作、权限与审批
- 自动发布与真实游戏内容管理系统
- 大型知识库、自训练模型与复杂路由
- 未经人工审核即可上线的完整长篇剧情
后续验证
- 补齐人工盲评并校准 AI 评分
- 验证 Persona、痛点优先级和编辑采纳意愿
- 补全失败父调用与重试链路记录
用户能完成“输入 → 多版本 → 评测 → 选择 → 编辑 → 导出”,且所有结果明确区分真实测试、估算与待验证。
完成、计划与假设严格分开
用户访谈待开展
已完成
- 已形成 Persona 假设、JTBD、痛点清单和访谈验证问题。
- 已用项目测试观察结构、差异化、异常和评分问题。
未完成 / 待验证
- 计划招募 5–8 名相关用户。
- 观察完整任务过程,验证 Persona、痛点优先级和 MVP 范围。
当前没有真实访谈记录、用户引语、满意度或业务结论;所有画像均为待验证的综合画像。
从输入到人工确认的完整路径
- 01
选择内容类型
在 7 类游戏文本任务中选择入口,切换匹配字段与 Prompt 模板。
- 02
输入结构化需求
补充角色、世界观、目标、风格、长度与限制条件。
- 03
生成 2–3 个版本
在统一 Schema 下输出不同动机、冲突、结构或语言方向。
- 04
五维评分与比较
查看人设一致性、创意性、可用性、语言风格和沉浸感。
- 05
人工编辑优化
由内容负责人选择候选、补充判断并提交定向优化。
- 06
导出并留痕
向用户导出 Markdown/TXT;后端另行记录模型调用,并可按条件导出 XLSX 用于排查与评测。
每张图都说明它解决什么问题
数字旁边必须有证据状态
生成 / 优化调用
合计 111 次真实模型调用。
正式测试平均响应
生成与继续优化的平均耗时。
生成阶段 AI 自评分
缺少人工盲评,不能证明真实质量。
Schema 修复重试
均为 ContentVersion 缺少 variant 字段。
生成 + 优化单流程成本
按公开价格测算,不是供应商账单。
场景时间节省率
基于人工流程假设,不是业务实测。
问题 → 定位 → 修复 → 回归验证
BC-001 / BC-002 · variant 字段缺失
真实测试- 问题
模型首次输出缺少必需的 variant 字段,页面结构解析失败。
- 定位
Schema 约束偶发失效,需要区分原始错误输出与修复请求。
- 修复
增加结构校验与一次修复重试,并保存 parent_call_id 与 retry_reason。
- 回归验证
两次第 2 次尝试成功;但失败父调用仍需完整持久化。
BC-003 · 失败父调用未完整落库
Review- 问题
导出表中成功记录完整,但两个 parent_call_id 找不到对应的首次失败调用。
- 定位
持久化逻辑偏向保存最终成功结果,削弱真实成功率与重试链路审计。
- 修复
将每一次供应商调用、错误类型和原始失败响应单独保存。
- 回归验证
待补回归;当前不能把 119 条 final_success 解释为模型 API 成功率 100%。
明确不能被模型或页面夸大的部分
- 内容与设定
- 模型可能补写不存在的设定或导致角色、世界观漂移,最终内容必须人工审核。
- 评测误导
- AI 自评分只作辅助,需人工盲评校准,不能用于绩效或唯一排序。
- 敏感数据
- 未授权剧情、个人信息、密钥与公司机密不得进入外部模型或公开日志。
- 版权与真实 IP
- 默认使用原创虚构内容,不生成或公开高度相似的官方角色、台词与资产。
- 稳定性与成本
- 需要控制超时、重试、长尾与输出 Token,避免失败重试风暴。
- 证据边界
- 当前在线前端可访问,但模型能力仍取决于后端服务和模型 API。
已提供在线前端版本;涉及模型调用的能力仍取决于后端服务和模型 API 的实际可用状态。页面不把估算效率写成真实业务结果。
以真实可核验的工作说明职责
- 把七类游戏文本任务拆成可复用字段与 Prompt 结构。
- 设计三版本生成、五维评测、人工选择、优化与导出闭环。
- 完成 FastAPI 后端、React/Vite 前端原型与在线前端部署。
- 整理 111 次真实调用记录、响应时间、Token、成本估算和 Bad Case。
- 明确人工审核、版权、敏感数据与失败日志的产品边界。
已依据公开仓库、在线作品、线上 FastAPI 文档、本地测试记录与 2026-08-06 模型调用导出文件校对;公开页面不展示真实 Prompt、用户输入或模型原始输出。
产品结构
这个原型没有把生成入口做成一个无约束聊天框,而是让用户先选择场景、填写约束,再比较三个候选版本。五维评估提供检查提示,最终选择和修改仍由人完成。
在线架构与入口
当前版本已经形成可公开验证的前后端链路:React/Vite 页面负责结构化输入与结果比较,线上 FastAPI 后端负责校验、Prompt 组装、模型调用、结构解析、评测和文件导出。模型凭据只配置在后端环境中,不进入浏览器,也不写入公开仓库。
一次在线请求按“浏览器 → FastAPI → OpenAI-compatible 模型 → 结构解析与评测 → 页面结果”的顺序完成。Markdown/TXT 属于面向用户的内容交付;模型调用 XLSX 则属于后端可观测性证据,两者用途不同。
模型调用可观测性
后端会为每次真实模型调用记录 run_id、call_id、操作类型、内容类型、Prompt 版本、模型、延迟、Token、解析与校验状态、重试原因和错误信息。公开接口 GET /api/model-calls/export 支持按日期、操作、内容类型、Prompt 版本、模型、成功状态和 run_id 筛选,并返回 XLSX 文件。
导出的工作簿包含四个工作表:
- 模型调用记录:调用标识、模型配置、延迟、Token、成功状态与错误字段。
- Prompt 与输出:完整 Prompt、原始响应、解析后响应及 SHA-256;仅用于受控排查。
- 错误记录:重试原因、错误类型、HTTP 状态、原始响应和发生时间。
- 汇总:调用次数、成功/失败、解析与校验失败、重试、usage 缺失、平均与 P50/P90 延迟、平均 Token,并按操作、模型、Prompt 版本和内容类型分组。
Token 直接读取模型供应商响应中的 usage 字段;供应商未返回时会标记为 usage 缺失,不使用本地字符数估算。这里记录的是单次模型调用,不是一整个用户任务的聚合成本;XLSX 也不包含价格或账单字段。
Swagger 实测步骤
- 打开线上 FastAPI 文档。
- 展开
GET /api/model-calls/export,点击 Try it out。 - 可按需填写
date_from、date_to、operation、content_type、prompt_version、model、success或run_id。 - 本次验证选择
success=true,点击 Execute。 - 服务返回 HTTP
200、Download file与 XLSX 文件名。 - 下载后核对四个工作表、字段与汇总结果;本次独立验证样本包含 1 条成功调用,错误记录为空。
它不是“用户历史记录”
当前前端没有账号体系、用户项目历史中心、账号隔离或跨设备同步。页面中的任务状态保存在当前浏览器会话内,刷新或离开页面后不会作为用户历史恢复。模型调用 XLSX 面向后端排查与评测,不能替代用户侧的任务保存功能。
当前限制
- 在线前端版本与后端已经公开,但模型调用能力仍受部署可用性与服务额度约束
- 用户侧任务历史、账号隔离与跨设备同步尚未实现
- 模型调用导出包含敏感排查字段,正式生产使用前需要补充认证、权限与脱敏
- 不包含真实游戏 IP、官方图片或音频
- 生成结果仍需人工检查事实、语气与合规风险